模仿学习
Imitation Learning
模仿学习让机器人照着人的示范学动作:人遥操作采集数据,模型学会从观测映射到动作,操作类策略多这样训练。
又称 行为克隆、示范学习、Learning from Demonstration
模仿学习是什么
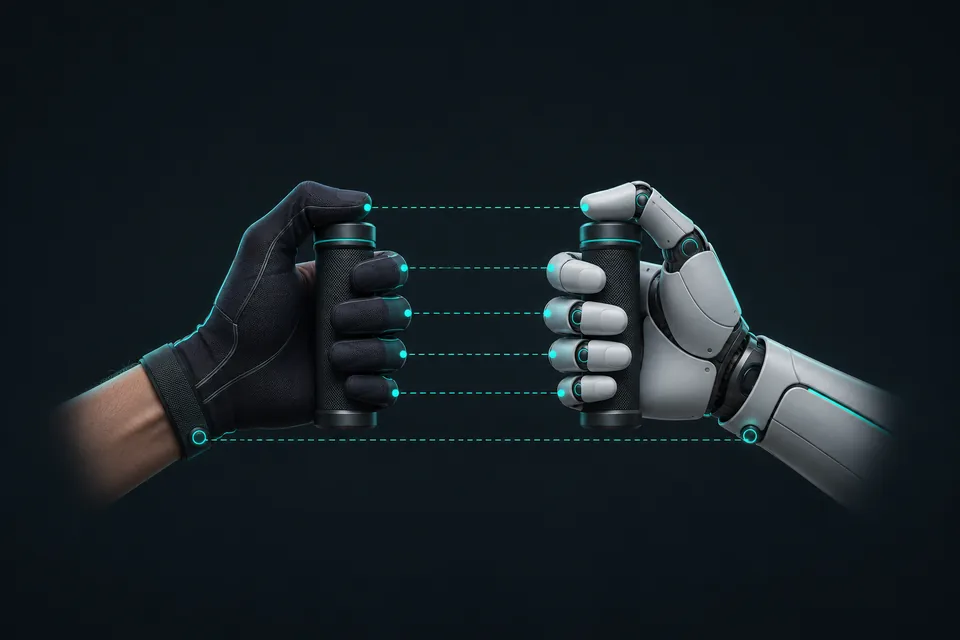
模仿学习让机器人照着人的示范学动作,人可以用这种方式教机器人各种技能。最直接的做法叫行为克隆:用监督学习,让模型学会把相机画面直接映射成动作。
示范多靠遥操作采集:人操控一套设备,机器人跟着动,系统同时记录动作。数据量和人力成正比,每条轨迹都要有人操作,这是机器人数据贵的原因之一。
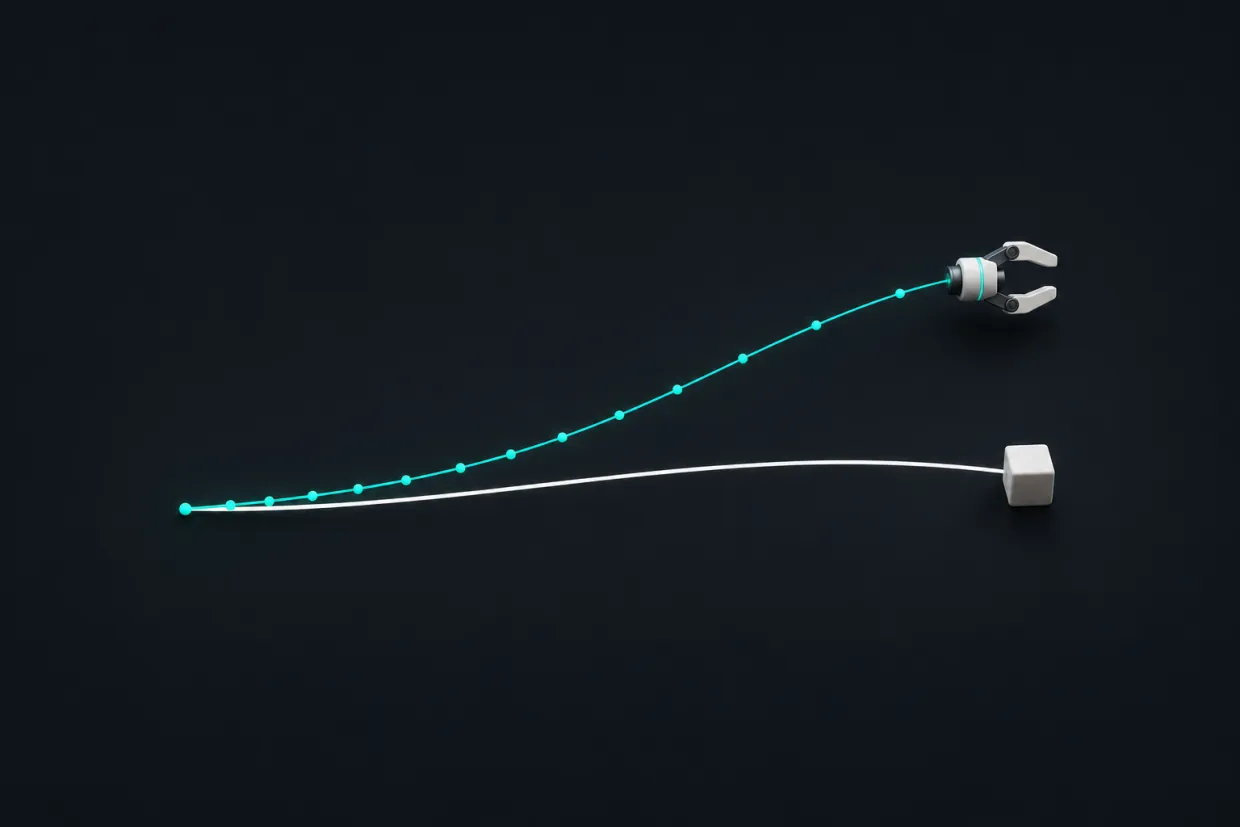
它的主要问题是误差累积。一步的小错会把机器人带到示范里没见过的状态,后面错得越来越多,最后难以恢复。精细操作里这个问题尤其突出。
在机器人里做什么
双臂精细操作
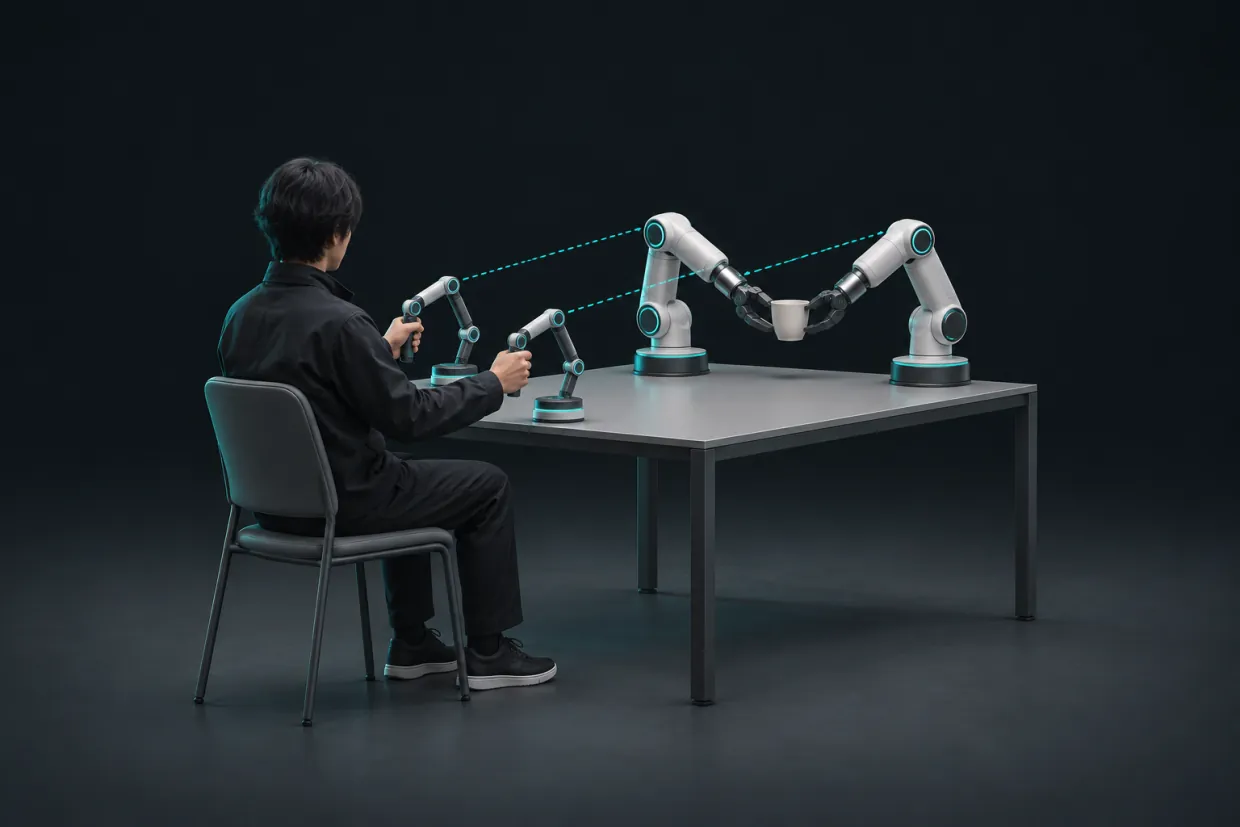
ACT 在低成本双臂系统 ALOHA 上学会 6 个难任务,比如打开半透明调料杯、插电池。每个任务只用 10 分钟示范,成功率 80–90%。
移动操作
Mobile ALOHA 给 ALOHA 加上移动底盘和全身遥操作。每个任务 50 条示范,再和静态 ALOHA 数据联合训练,能自主完成炒虾上菜这类任务。
人形机器人遥操作
GR00T N1 的人形数据靠遥操作采集:VIVE 追踪器记手腕位姿,Xsens 手套记手指动作,再用逆运动学映射到傅利叶 GR1,控制频率 20 Hz。
多机构采集大数据集
DROID 用 Meta Quest 2 手柄遥控 Franka 机械臂,50 位采集员花 12 个月,采到 7.6 万条示范轨迹。所有站点用同一套硬件。
训练 VLA 大模型
VLA 也靠示范数据训练。OpenVLA 用了 97 万条真实机器人示范,Figure 称 Helix 用了约 500 小时遥操作数据。
关键数字
- 10分钟ACT 学一个精细任务所需的示范量,约 50 条轨迹,成功率 80–90%来源:arxiv.org
- <$20kALOHA 双臂遥操作系统的整套成本来源:arxiv.org
- 50HzALOHA 遥操作频率,ACT 论文的用户测试里降到 5 Hz 后遥操作时间增加 62%来源:arxiv.org
- 76k条DROID 数据集的示范轨迹数,约 350 小时,564 个场景,86 个任务来源:arxiv.org
- 46.9%Diffusion Policy 论文报告的相比已有方法的平均提升来源:arxiv.org
常见问题
- 模仿学习和强化学习有什么区别?
- 模仿学习有示范,直接学人的动作,比如 Mobile ALOHA 用行为克隆。强化学习不靠示范,比如 OpenAI 的灵巧手完全在仿真里自己练。模仿学习的短板是误差累积,一旦偏离示范,就容易走到难以恢复的状态。
- 要多少条示范才够?
- 看任务和方法。ACT 的精细任务约 50 条。Mobile ALOHA 每任务 50 条,要配合联合训练。Gemini Robotics 学短任务最少 100 条。π0 微调最简单的任务要 5 小时数据,最复杂的 100 小时以上。
- 遥操作设备有哪些?
- 常见四类。主从臂:人推动主臂,从臂跟随,ALOHA 用这种。VR 手柄:DROID 用 Quest 2。追踪器加手套:GR00T N1 用 VIVE 和 Xsens。手持夹爪:UMI 用它采野外数据。ACT 论文发现,精细任务上关节映射比手持 VR 手柄效果好。
- 误差累积怎么解决?
- 一种办法是 DAgger:让策略自己跑,再请专家纠正。但用遥操作做标注费时又别扭。ACT 改成一次预测一串动作,缩短任务的有效步数,再把重叠的动作块做集成,让轨迹更平滑。
- ACT 和 Diffusion Policy 有什么区别?
- 两者都预测一段动作。ACT 用 Transformer,按条件 VAE 训练,捕捉人类示范的差异。Diffusion Policy 把策略写成条件去噪扩散过程,从噪声逐步修成动作,能表达同一场景下的多种做法。
- 模仿学习和 VLA 是什么关系?
- 模仿学习是训练方法,VLA 是模型类型。VLA 也用示范数据训练,但底座换成预训练的视觉语言模型,能接语言指令。ACT 这类策略规模小得多,约 8000 万参数,每个任务从头训练。
来源
- Zhao 等 · Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware(ACT / ALOHA,arXiv 摘要页)arxiv.org
- Zhao 等 · ACT / ALOHA 论文全文(arXiv HTML 版)arxiv.org
- Fu 等 · Mobile ALOHA: Learning Bimanual Mobile Manipulation with Low-Cost Whole-Body Teleoperation(arXiv 2401.02117)arxiv.org
- Ross 等 · A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning(DAgger,arXiv 1011.0686)ar5iv.labs.arxiv.org
- Chi 等 · Diffusion Policy: Visuomotor Policy Learning via Action Diffusion(arXiv 摘要页)arxiv.org
- Chi 等 · Diffusion Policy 论文全文(ar5iv HTML 版)ar5iv.labs.arxiv.org
- Khazatsky 等 · DROID: A Large-Scale In-The-Wild Robot Manipulation Dataset(arXiv 2403.12945)arxiv.org
- NVIDIA · GR00T N1: An Open Foundation Model for Generalist Humanoid Robots(arXiv 2503.14734)arxiv.org
- Kim 等 · OpenVLA: An Open-Source Vision-Language-Action Model(arXiv 2406.09246)arxiv.org
- Physical Intelligence · π0: A Vision-Language-Action Flow Model for General Robot Control(arXiv 2410.24164)arxiv.org
- Figure · Helix: A Vision-Language-Action Model for Generalist Humanoid Control(官方技术文章)figure.ai
- Google DeepMind · Gemini Robotics: Bringing AI into the Physical World(arXiv 2503.20020)arxiv.org
- Chi 等 · Universal Manipulation Interface(UMI,arXiv 2402.10329)arxiv.org
- OpenAI · Learning Dexterous In-Hand Manipulation(arXiv 1808.00177)arxiv.org
核验于 2026-11-06