VLA 模型
Vision-Language-Action Model
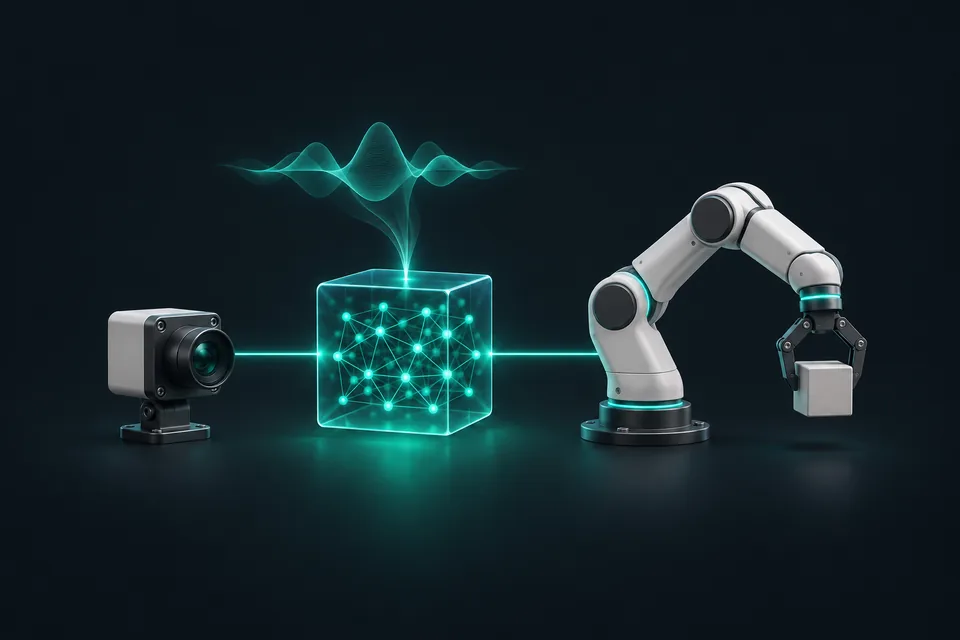
VLA 是视觉-语言-动作模型:输入相机画面和语言指令,直接输出机器人动作,多用真实机器人示范数据训练。
又称 视觉-语言-动作模型、视觉语言动作模型
VLA 模型是什么
VLA 是视觉(Vision)、语言(Language)、动作(Action)三个词的缩写:输入相机画面和语言指令,直接输出机器人的动作。这个叫法来自 Google DeepMind 2023 年的 RT-2 论文。
它的底座通常是在互联网数据上预训练过的视觉语言模型(VLM),再用机器人数据微调。模型既带着网上学到的知识,又学会把观测映射成动作。
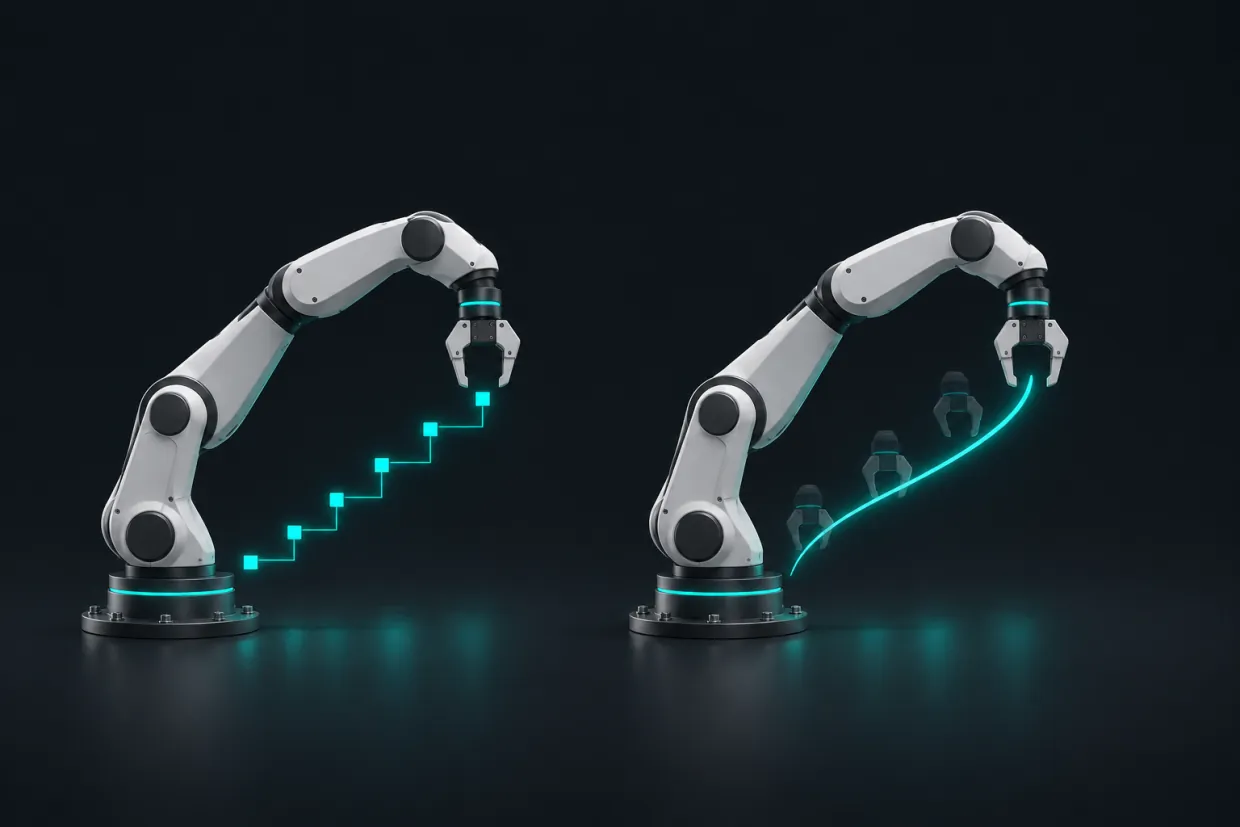
动作的输出方式分两类。RT-2、OpenVLA 把动作离散成 256 档,当作文字 token 预测。π0、GR00T N1 用流匹配(扩散模型的一种变体)生成连续动作,一次出一串,这一串叫动作块。
在机器人里做什么
控制多种机械臂
OpenVLA 开箱就能控制多种机器人,也能快速适配新机器人。论文在 WidowX 机械臂和 RT-1、RT-2 用的移动操作机器人上测试,并在 Franka 桌面任务上做了微调。
叠衣服这类多步任务
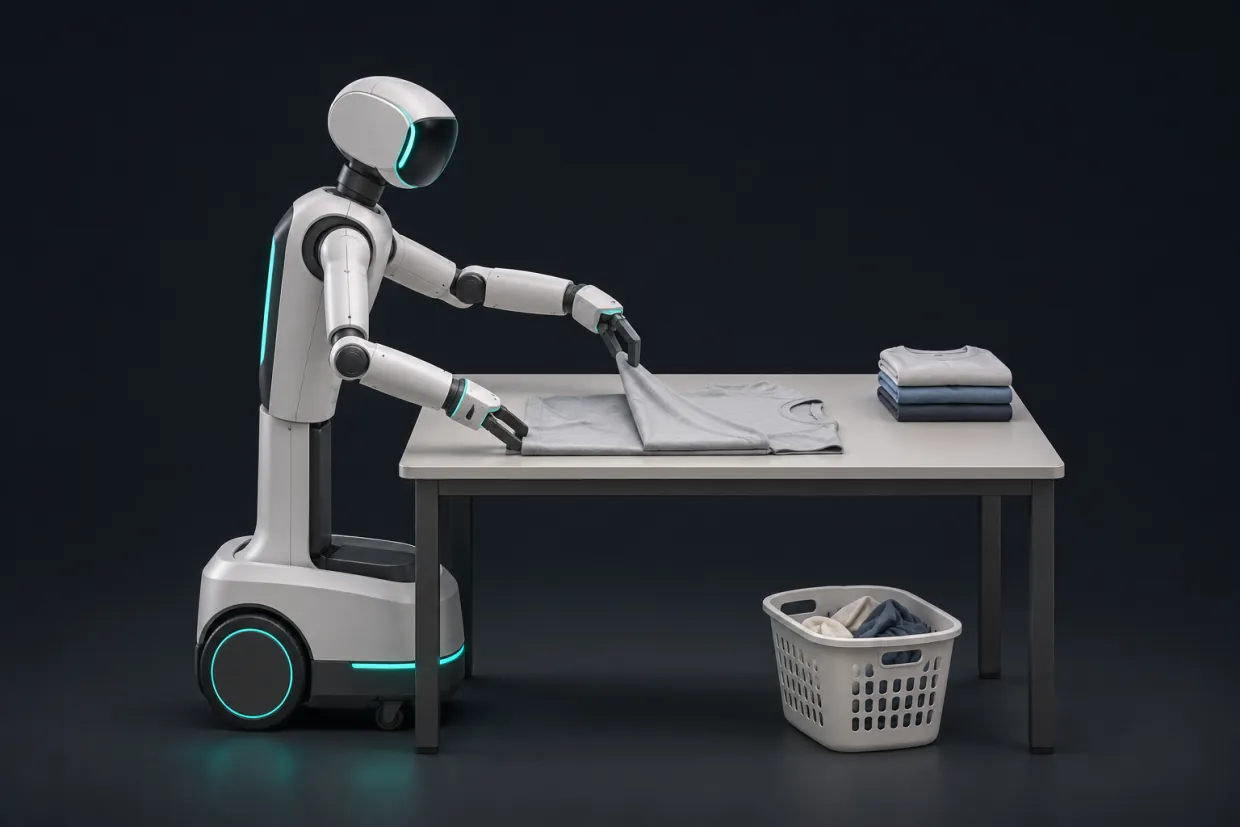
π0 控制移动机械臂叠衣服:从烘干机取衣、装篮、搬到桌边,再逐件折叠。它用 7 种机器人配置、68 个任务的数据预训练,再针对任务微调。
控制人形机器人上半身
Figure 称 Helix 用一个模型控制人形上半身,手指、手腕、头和躯干共 35 个自由度,每秒 200 次。模型跑在机器人自带的两块低功耗嵌入式 GPU 上。
快慢两套系统分工
GR00T N1 的视觉语言模块每秒跑 10 次,负责理解场景和任务。动作模块每秒输出 120 次。Helix 也这样分:慢系统 7–9 Hz,快系统 200 Hz。
一个模型跨多种机器人
同一个模型可以服务不同形态的机器人。GR00T N1 支持从桌面机械臂到灵巧人形。π0 的训练数据混合了单臂、双臂和移动操作平台。
关键数字
- 7B参数OpenVLA 的参数量,用 97 万条真实机器人示范训练来源:arxiv.org
- 约 6HzOpenVLA 在一张 RTX 4090 上的推理频率来源:arxiv.org
- 21,500A100 小时OpenVLA 的训练算力:64 张 A100 训练 14 天来源:arxiv.org
- 10,000+小时π0 预训练使用的机器人数据量来源:arxiv.org
- 200HzFigure 公布的 Helix 动作频率,动作空间 35 个自由度来源:figure.ai
常见问题
- VLA 和 VLM 有什么区别?
- VLM 输入图像和文字,输出自然语言。VLA 多了动作输出,能控制机器人。RT-2 的做法是把动作写成文本 token,和语言 token 一样放进训练集。
- VLA 和具身大脑有什么区别?
- 具身大脑做高层规划,把长任务拆成子任务。VLA 做底层控制,根据指令和画面输出动作。Gemini Robotics 就有两个模型:ER 版做具身推理,主模型直接控制机器人。也有研究让底层策略自己先推理再出动作。
- 有哪些代表性的 VLA 模型?
- RT-2 是这个名字的出处。OpenVLA 和 GR00T N1 公开了模型权重。π0 用流匹配输出连续动作。Gemini Robotics 基于 Gemini 2.0。Helix 是 Figure 用在人形机器人上的模型。
- VLA 这么大,怎么做到实时控制?
- 一是一次出一段动作。π0 在 50 Hz 的机器人上每 0.5 秒推理一次,中间执行 25 个动作。二是快慢分工,大模型低频理解,小模型高频出动作。早期的 RT-2 放在云端,55B 版本只有 1–3 Hz。
- 训练一个 VLA 要多少数据和算力?
- 各家差别很大。OpenVLA 用 97 万条示范,64 张 A100 训练 14 天。π0 预训练用了超过 1 万小时机器人数据。GR00T-N1-2B 预训练约 5 万 H100 GPU 小时。微调小得多:π0 最简单的任务只要 5 小时数据,最复杂的 100 小时以上。
- 消费级显卡能微调 VLA 吗?
- OpenVLA 论文说可以。用 LoRA(低秩适配)只训练 1.4% 的参数,效果能追平全量微调。全量微调用 8 张 A100 跑 5–15 小时。部署时 4 位量化能把显存占用减少一半以上。
来源
- Google DeepMind · RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control(arXiv 摘要页)arxiv.org
- Google DeepMind · RT-2 论文全文(arXiv PDF)arxiv.org
- Kim 等 · OpenVLA: An Open-Source Vision-Language-Action Model(arXiv 2406.09246)arxiv.org
- Physical Intelligence · π0: A Vision-Language-Action Flow Model for General Robot Control(arXiv 2410.24164)arxiv.org
- NVIDIA · GR00T N1: An Open Foundation Model for Generalist Humanoid Robots(arXiv 2503.14734)arxiv.org
- Figure · Helix: A Vision-Language-Action Model for Generalist Humanoid Control(官方技术文章)figure.ai
- Google DeepMind · Gemini Robotics: Bringing AI into the Physical World(arXiv 2503.20020)arxiv.org
- Ma 等 · A Survey on Vision-Language-Action Models for Embodied AI(arXiv 2405.14093)arxiv.org
核验于 2026-11-06