一句话变成一个动作,
中间隔着五层大脑。

从听懂「把桌上的杯子递给我」,到每个关节转起来,
机器人的大脑分成快慢不同的五层。
看懂每一层做什么、多快、靠什么学会。

5层分工117个相关模型上千倍最快和最慢的差距

以通用人形机器人为例 · 概念教学配图

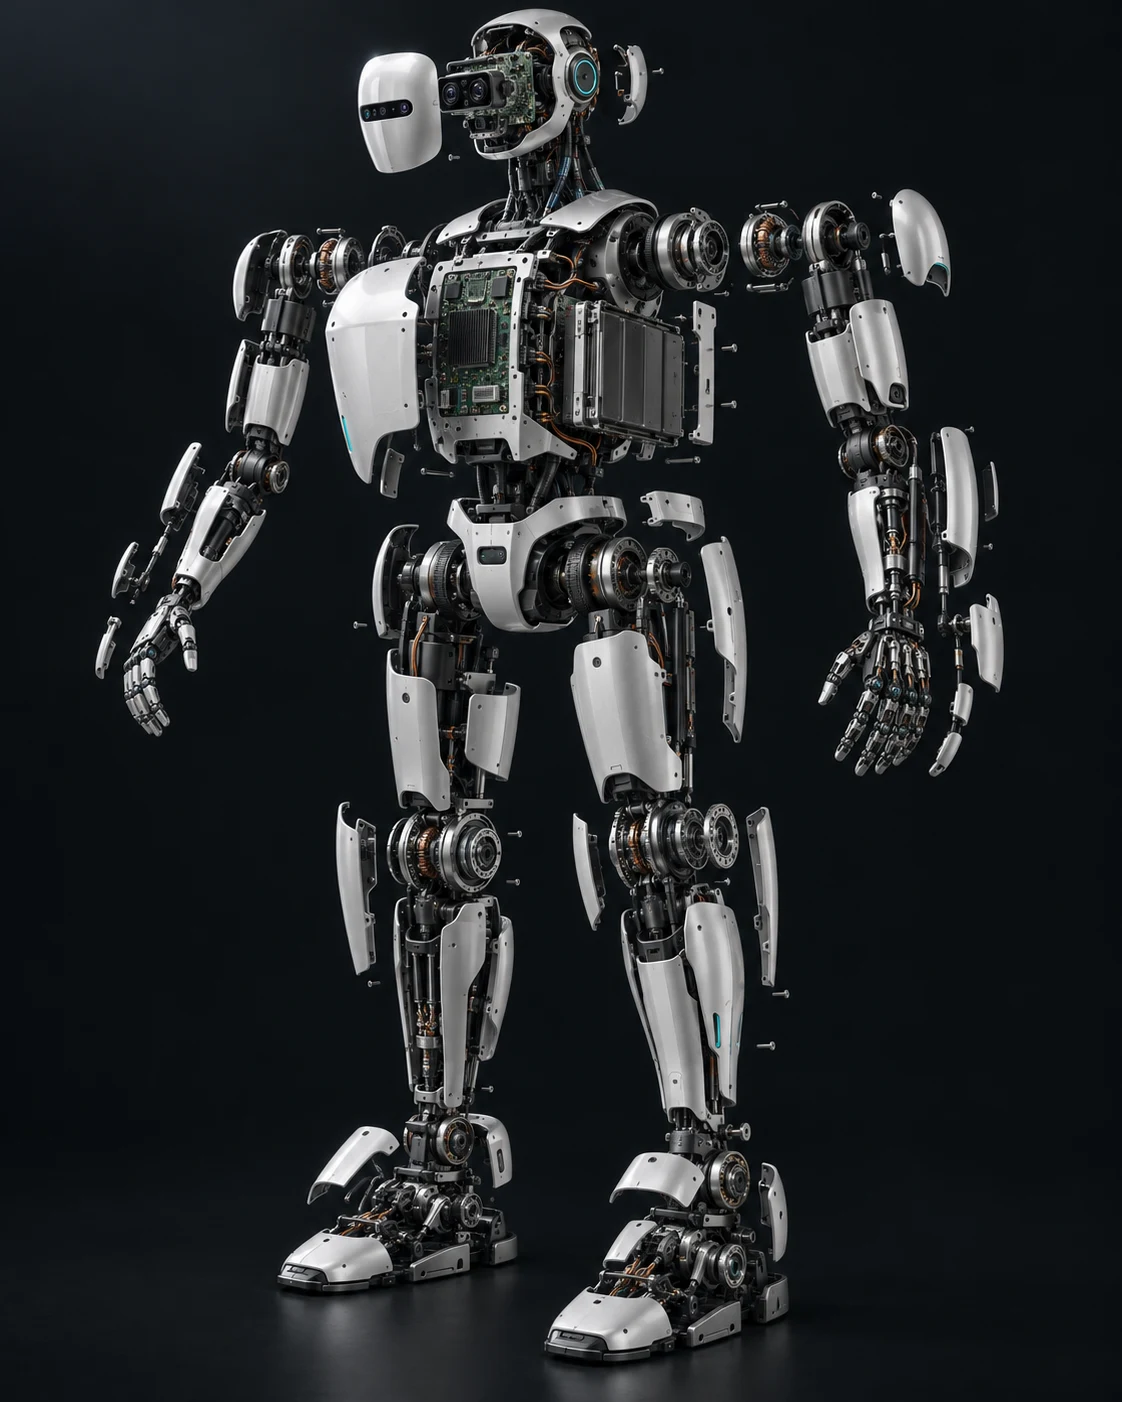
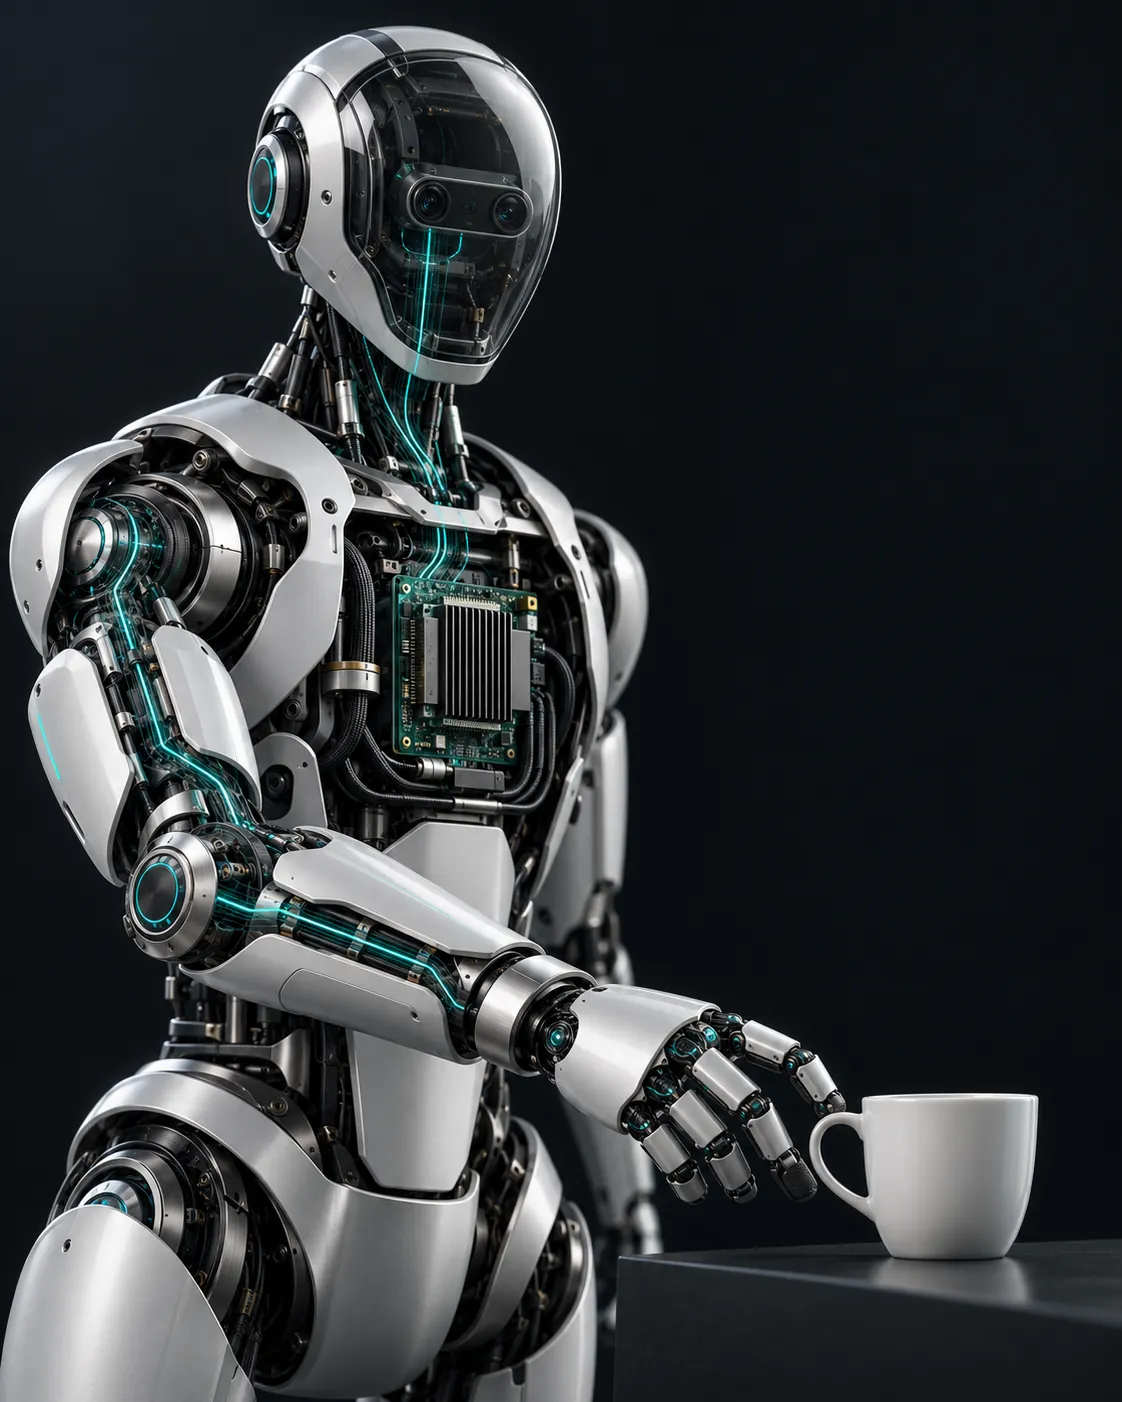
人形机器人上半身,头部半透明露出相机,胸腔露出计算模块,青色细线从头部经胸腔沿手臂延伸到手,手正伸向一只白色杯子

一句指令,走一遍五层

从听到指令到关节转起来,每一层只做一件事,再把结果交给下一层。

指令「把桌上的杯子递给我」

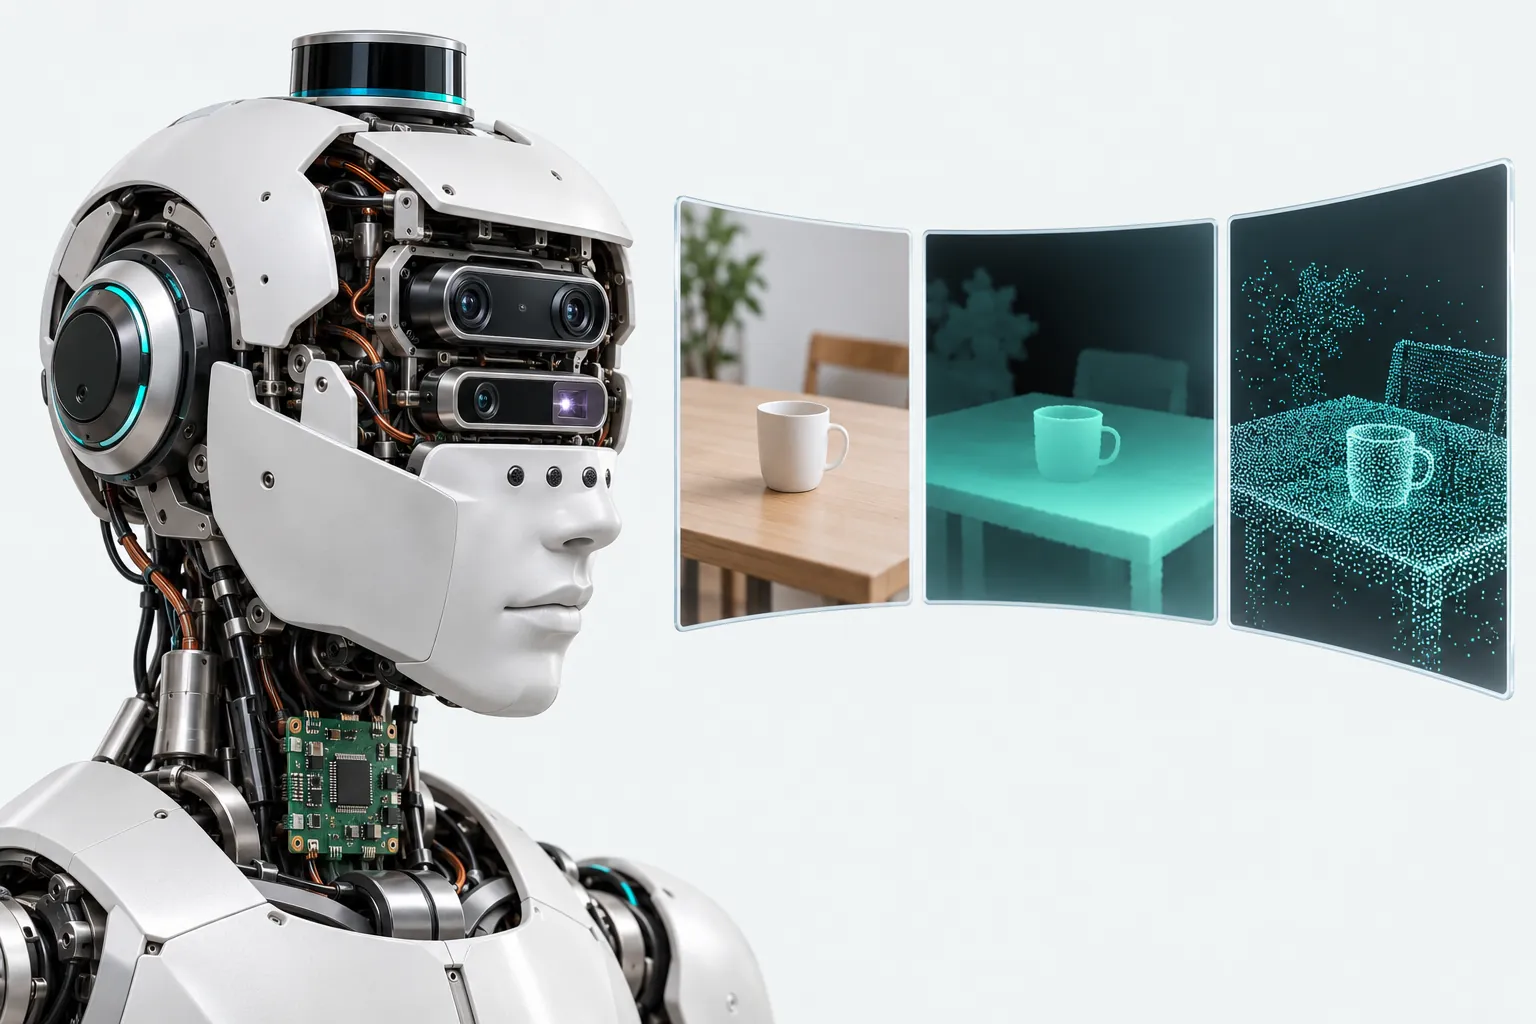
人形机器人头部打开外壳,露出双目相机、深度相机、激光雷达和惯性测量单元;旁边三块面板分别是同一张桌子和杯子的彩色图、深度图和点云

第 01 层 · 感知

看见杯子

相机拍下桌面,深度相机测出杯子离手有多远;关节编码器和 IMU 报告身体此刻的姿态。

交给「理解与规划」图像、深度、身体状态

1 / 5
越靠近电机,算得越快各层每秒更新多少次(对数刻度,典型量级,不同机器人差别很大)
  • 感知 · 深度相机每秒 30–90 帧(RealSense D400)
  • 理解与规划每秒几次(Helix 7–9 次,GR00T N1 10 次)
  • 动作生成每秒 50–200 次(π0、GR00T N1、Helix)
  • 全身运动控制强化学习策略每秒约 50 次
  • 关节指令宇树 SDK 底层指令每秒 500 次
  • 驱动板控制环每秒几千到几万次(ODrive 8 千次)

五层分工

越往上越像「想」,越往下越像「反射」。上面三层多是大模型,下面两层多是控制算法。

人形机器人头部打开外壳,露出双目相机、深度相机、激光雷达和惯性测量单元;旁边三块面板分别是同一张桌子和杯子的彩色图、深度图和点云

01Perception

感知

像眼睛、耳朵和身体的感觉

把周围的环境和自己身体的状态,变成计算机能处理的数据。

机器人有两类感觉:一类看外面,靠相机、深度相机、激光雷达和麦克风;一类感觉自己,靠关节里的角度编码器、惯性测量单元(IMU),以及脚底和指尖的力与触觉传感器。

这一层只负责把信号变成数据,不负责理解。画面里哪个是杯子、要不要去拿,是下一层的事。

收到
光线、声音、接触,以及身体自己的运动
交出
彩色图像、深度、点云,关节角度、身体姿态、接触力
多快
深度相机每秒 30–90 帧(RealSense D400);关节角度等身体状态随底层控制一起更新
跑在哪
传感器和它们的处理芯片,数据汇总到计算模块
怎么来的
传感器本身不用学;画面里有什么,要靠后面几层的模型去认
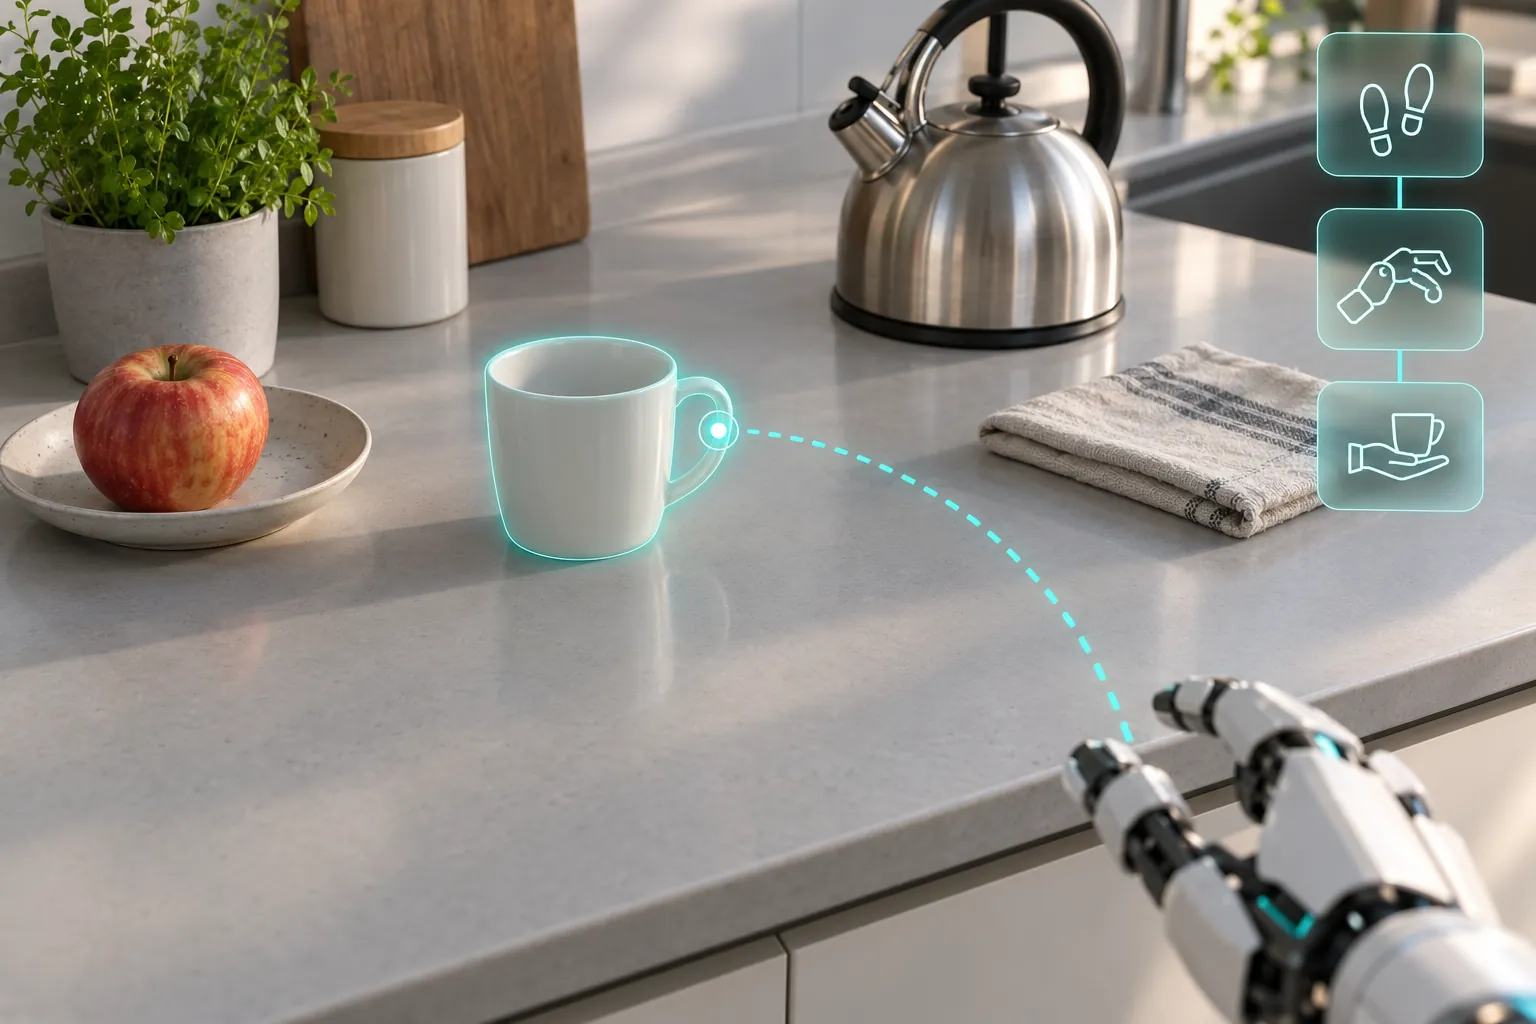
从机器人视角看厨房台面,白色杯子被青色轮廓标出,杯柄上有目标点,一条虚线弧从画面边缘指向杯柄;右上角三个图标表示走过去、抓住、递出三步

02Reasoning & Planning

理解与规划

像人想事情的那部分

听懂指令、看懂场景,把一件事拆成几步,想清楚先做什么、后做什么。

这一层通常是一个视觉语言模型:既能读懂「把杯子递给我」,也能在画面里找到杯子和你。模型库把这一类叫「具身大脑」。

它不直接控制电机,输出的是更高一层的结果:先做什么、后做什么,目标在画面的哪个位置。有的系统把这一层和下一层做成同一个模型的两部分,见下面的「快慢两套系统」。

收到
语音或文字指令、相机画面
交出
一步步的子任务,目标在哪、该抓哪里
多快
慢:每秒几次,或者做完一步再想下一步
跑在哪
机身上的 AI 计算模块;更大的模型也可以放在云端
怎么来的
以大语言模型、视觉语言模型为底子,再用机器人场景的数据继续训练:空间关系、哪里能抓、怎么拆任务
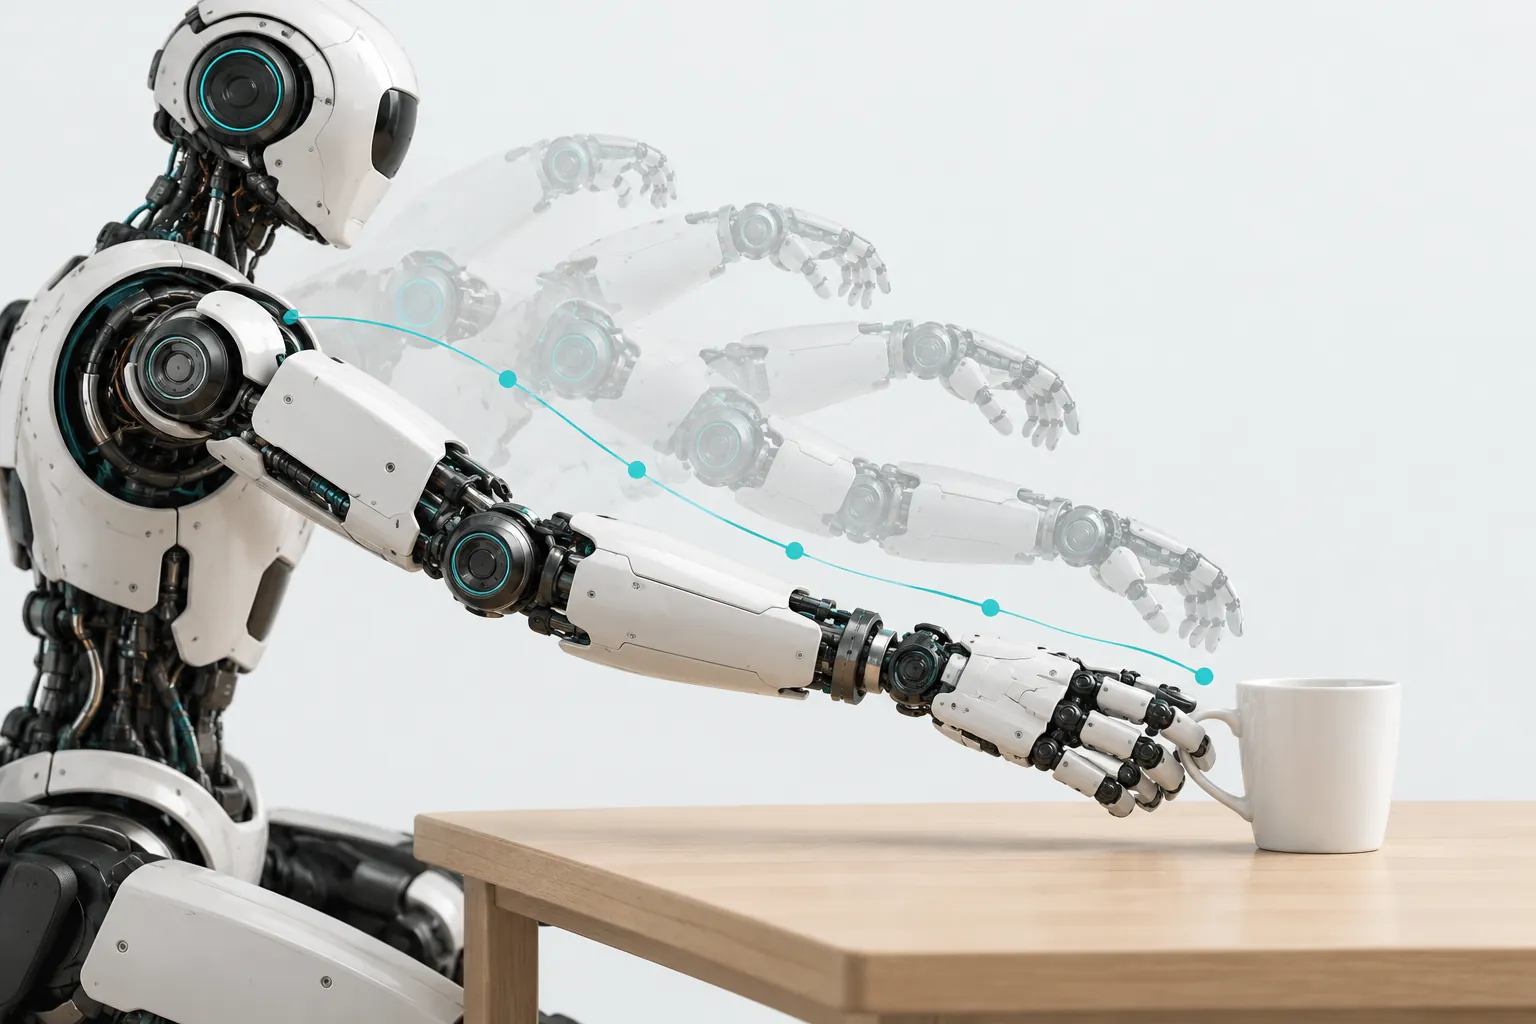
机器人手臂伸向桌上的白色杯子,沿途是几个半透明的手臂姿态,青色弧线和小点标出手腕经过的路径,最后手指握住杯柄

03Vision-Language-Action

动作生成

像熟练的手眼配合

盯着画面,把「抓住杯柄」变成手臂和手指接下来一小段时间的连续动作。

VLA 是视觉(Vision)、语言(Language)、动作(Action)三个词的缩写:输入画面和指令,直接输出动作。模型库里这一类最多。

大模型算一次要几十到上百毫秒,来不及每个控制节拍都重算。常见做法是一次生成接下来一小段的动作(叫「动作块」),一边执行一边生成下一段。不带语言输入的模仿学习策略,如 ACT、Diffusion Policy,也做这一层的事。

收到
相机画面、当前这一步的子任务、身体状态
交出
接下来一小段时间里,手臂和手指的一串目标姿态
多快
动作每秒输出 50–200 次(π0、GR00T N1、Helix);大模型本身每秒只推理几次(OpenVLA 在 RTX 4090 上约 6 次)
跑在哪
机身上的 AI 计算模块(GPU)
怎么来的
模仿学习:人通过遥操作一遍遍示范,模型学会「看到这样的画面,手该怎么动」
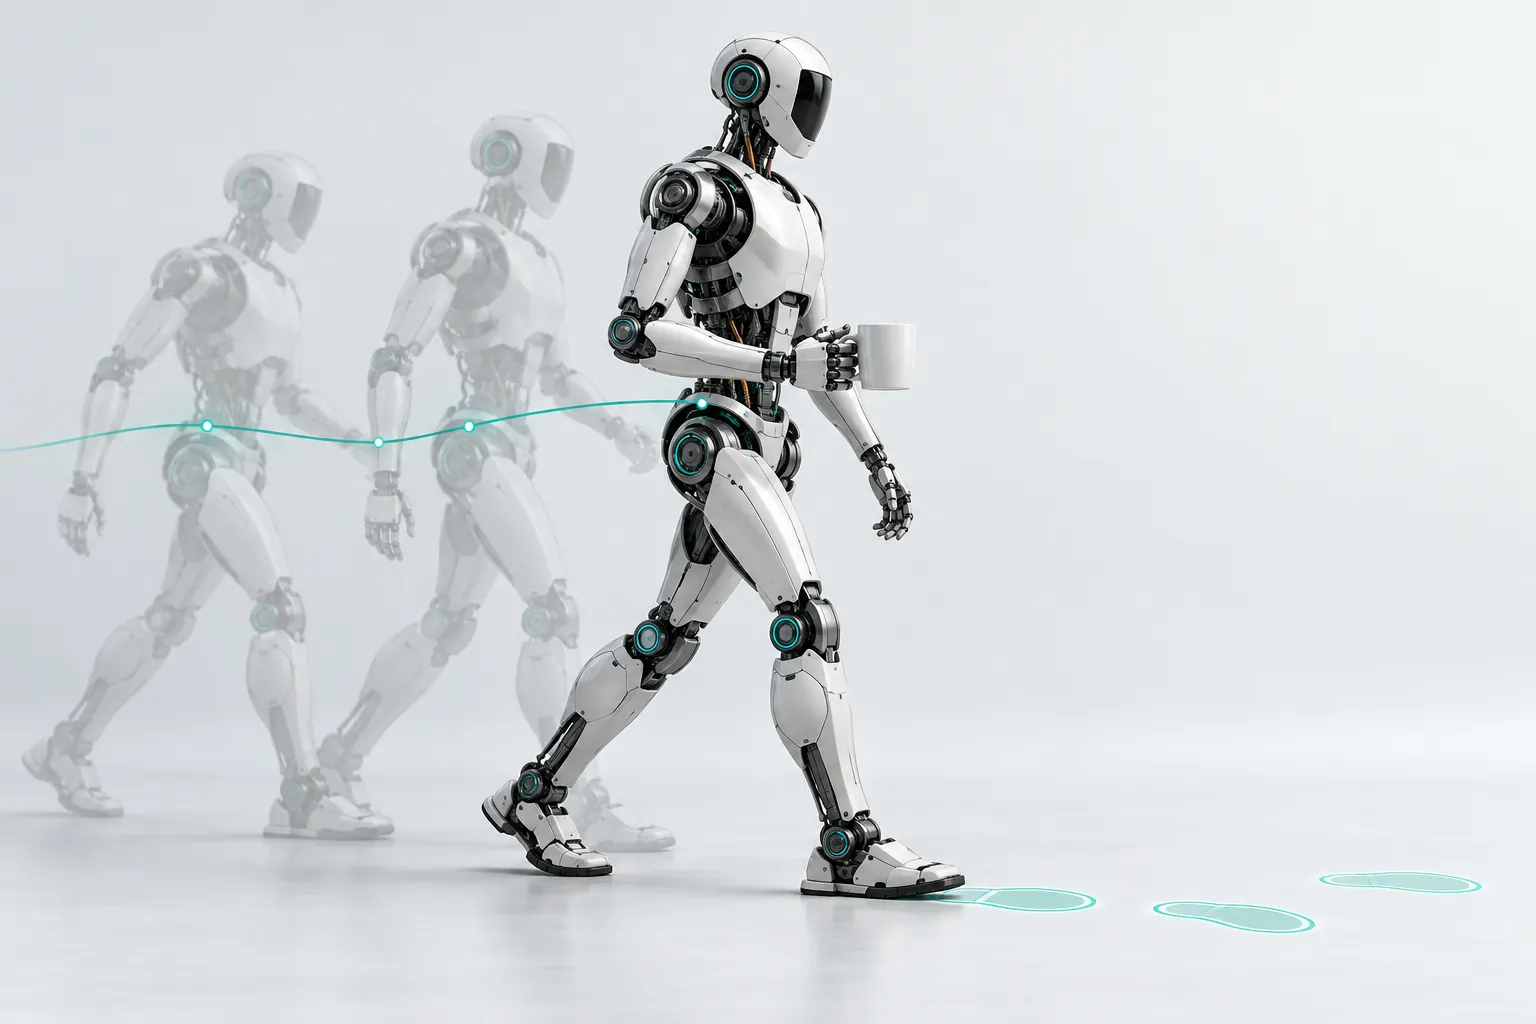
人形机器人手里端着白色杯子向前行走,身后有前几步的半透明身影,青色线条标出重心经过的路径,地面上有下一步的脚印

04Whole-Body Control

全身运动控制

像小脑,管平衡和协调

让全身配合手上的动作:伸手时不摔倒,走路、被推一下也能站稳。

伸手拿杯子时,身体的重心会往前移。这一层调整腰、腿和脚踝,让机器人站得住;走路、上台阶、被推一下还能站稳,也归这一层管。

过去主要靠工程师写的动力学模型来算,现在越来越多用强化学习,在仿真里练好再迁移到真机;人的动作捕捉数据也常拿来让动作更像人。

收到
上一层给的目标(手要到哪、往哪走),身体姿态、脚底受力
交出
全身每个关节的目标角度
多快
强化学习策略每秒约 50 次(宇树开源的 unitree_rl_gym 默认如此)
跑在哪
运动控制板或 AI 计算模块
怎么来的
多在仿真里用强化学习练成:成千上万个虚拟机器人同时摔倒、爬起、再走,练好了再搬到真机上
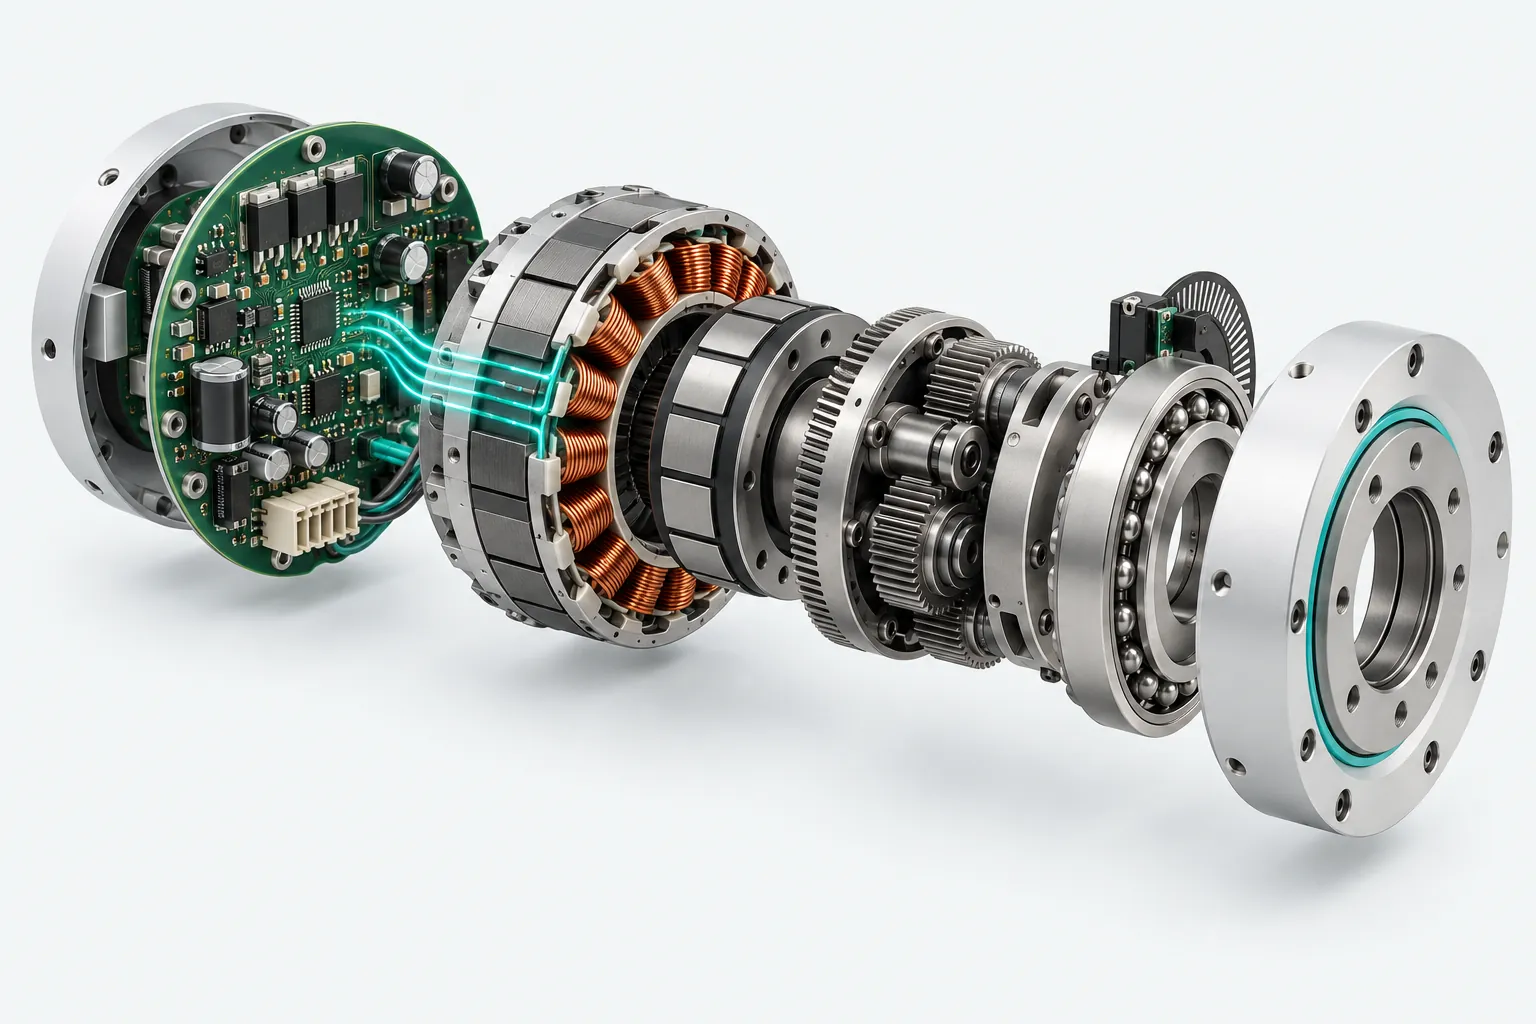
一个机器人关节执行器的剖切展开图:铜绕组、转子磁体、减速器、输出轴承和编码器,后面是带功率管和电容的电机驱动板,青色细线从驱动板连到绕组

05Joint Servo

关节伺服

像脊髓反射和肌肉

让每个关节准确、及时地转到目标角度。

驱动板把目标角度和编码器读到的实际角度一比,差多少,就给电机多大的电流去追。这样的比较和修正在驱动板里每秒进行几千到几万次。

这一层是软件和硬件的分界。再往下就是电机、减速器和轴承,在拆解图谱的「关节内部」里能看到。

收到
目标角度,以及要多「硬」、多「软」的参数
交出
电机电流,最后变成关节的转动和力
多快
底层指令每秒约 500 次(宇树 SDK 示例);驱动板内部的控制环每秒几千到几万次
跑在哪
每个关节里的电机驱动板
怎么来的
一般不用学:用的是经典控制算法(PD 控制、磁场定向控制 FOC),参数靠调试和标定

快慢两套系统

大模型想得深但算得慢,控制要快但不必想太多。现在常见的做法,是把「想」和「动」拆成两个配合的系统。

慢系统 · 想

一个视觉语言模型,看画面、听指令,理解场景、决定下一步做什么。每秒更新几次到十次左右。

快系统 · 动

一个小得多的动作模型,接过慢系统的意图,结合最新画面和身体状态,每秒输出几十到两百次动作。

公开实例慢系统(想)快系统(动)出处
HelixFigure AI · 2025-0270 亿参数的视觉语言模型,每秒 7–9 次,理解画面和语言指令8000 万参数的动作模型,每秒 200 次,控制上半身 35 个自由度;两套都跑在机身的嵌入式 GPU 上原文
GR00T N1NVIDIA · 2025-03Eagle-2 视觉语言模型,在 L40 GPU 上每秒 10 次扩散变换器(流匹配)动作模型,每秒输出 120 次动作原文
π0Physical Intelligence · 2024-1030 亿参数的 PaliGemma 视觉语言模型3 亿参数的「动作专家」,用流匹配一次生成一段动作,最高每秒 50 次;两部分在同一个模型里原文
Gemini Robotics 1.5Google DeepMind · 2025-09Gemini Robotics-ER 1.5 像高层大脑一样安排任务,可以调用 VLA 或其他工具Gemini Robotics 1.5(VLA)把画面和指令变成电机指令原文
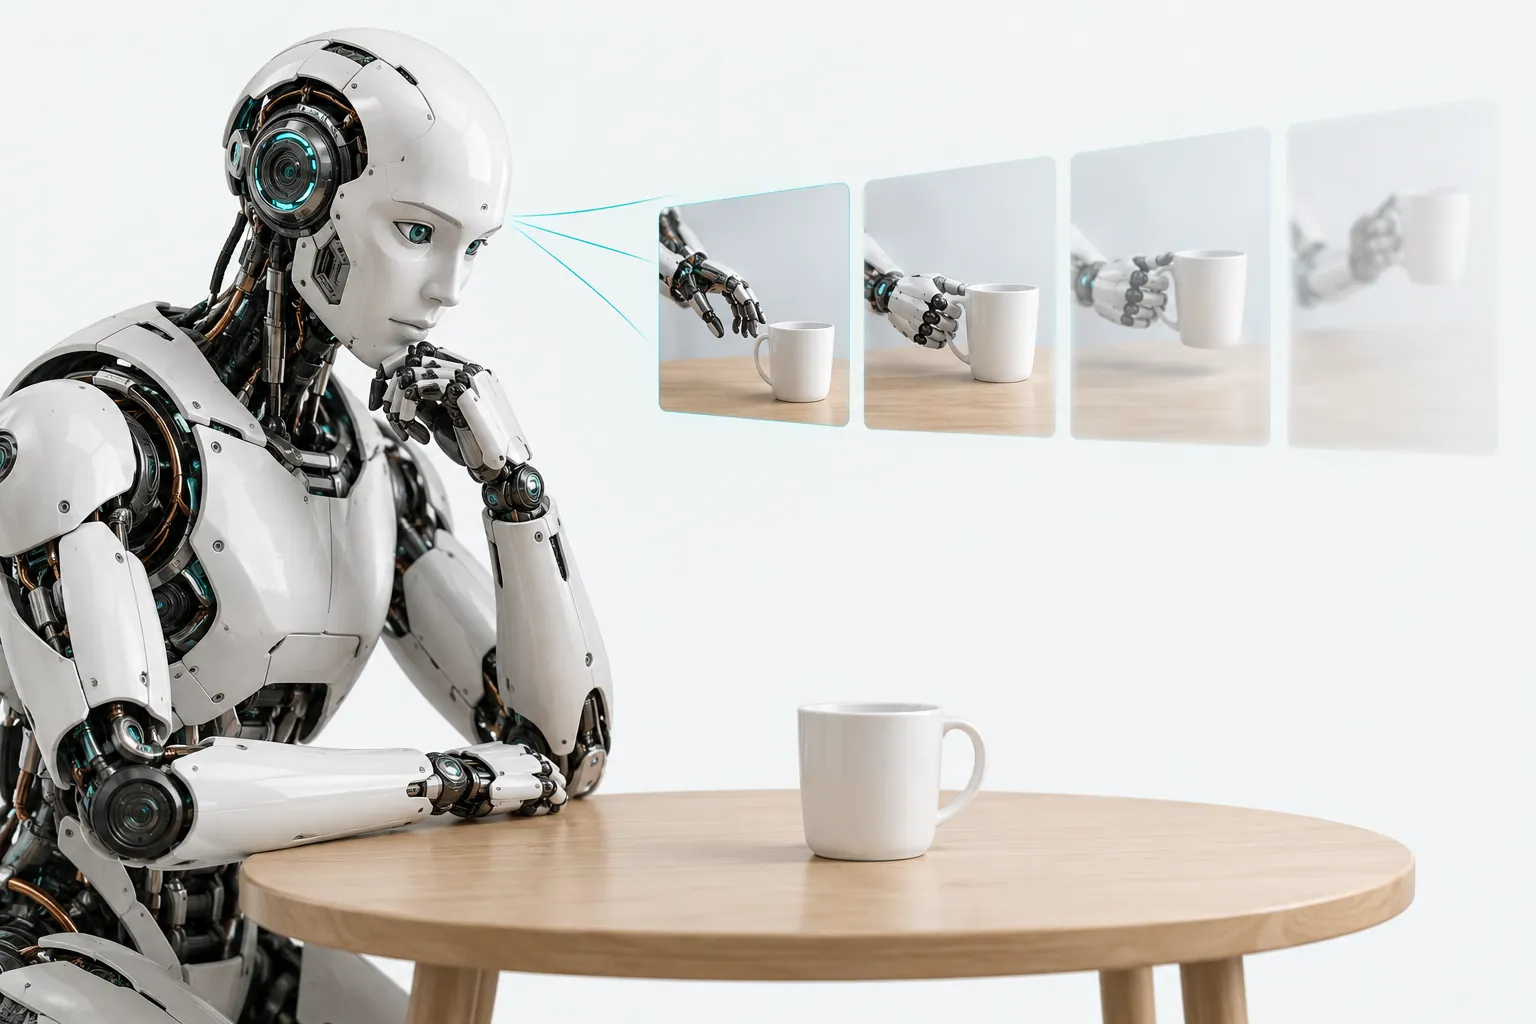
人形机器人面对桌上的白色杯子,旁边一排半透明画框依次显示手靠近杯子、握住、提起的预测画面,越往右越淡

世界模型:先在脑子里预演

世界模型学的是「接下来会发生什么」:给它眼前的画面和一个动作,它预测之后的画面会变成什么样。

多数时候它不直接控制机器人,而是在训练和检验时帮忙;也有新模型把预测画面和生成动作合在一起做。

  • 造数据真机示范又贵又慢,用世界模型生成大量合成视频,补充训练数据。
  • 先预演在模型里试几种做法,看哪种结果好,再到真机上执行。
  • 做评测不用每次都上真机,在世界模型里给不同策略打分、排序。
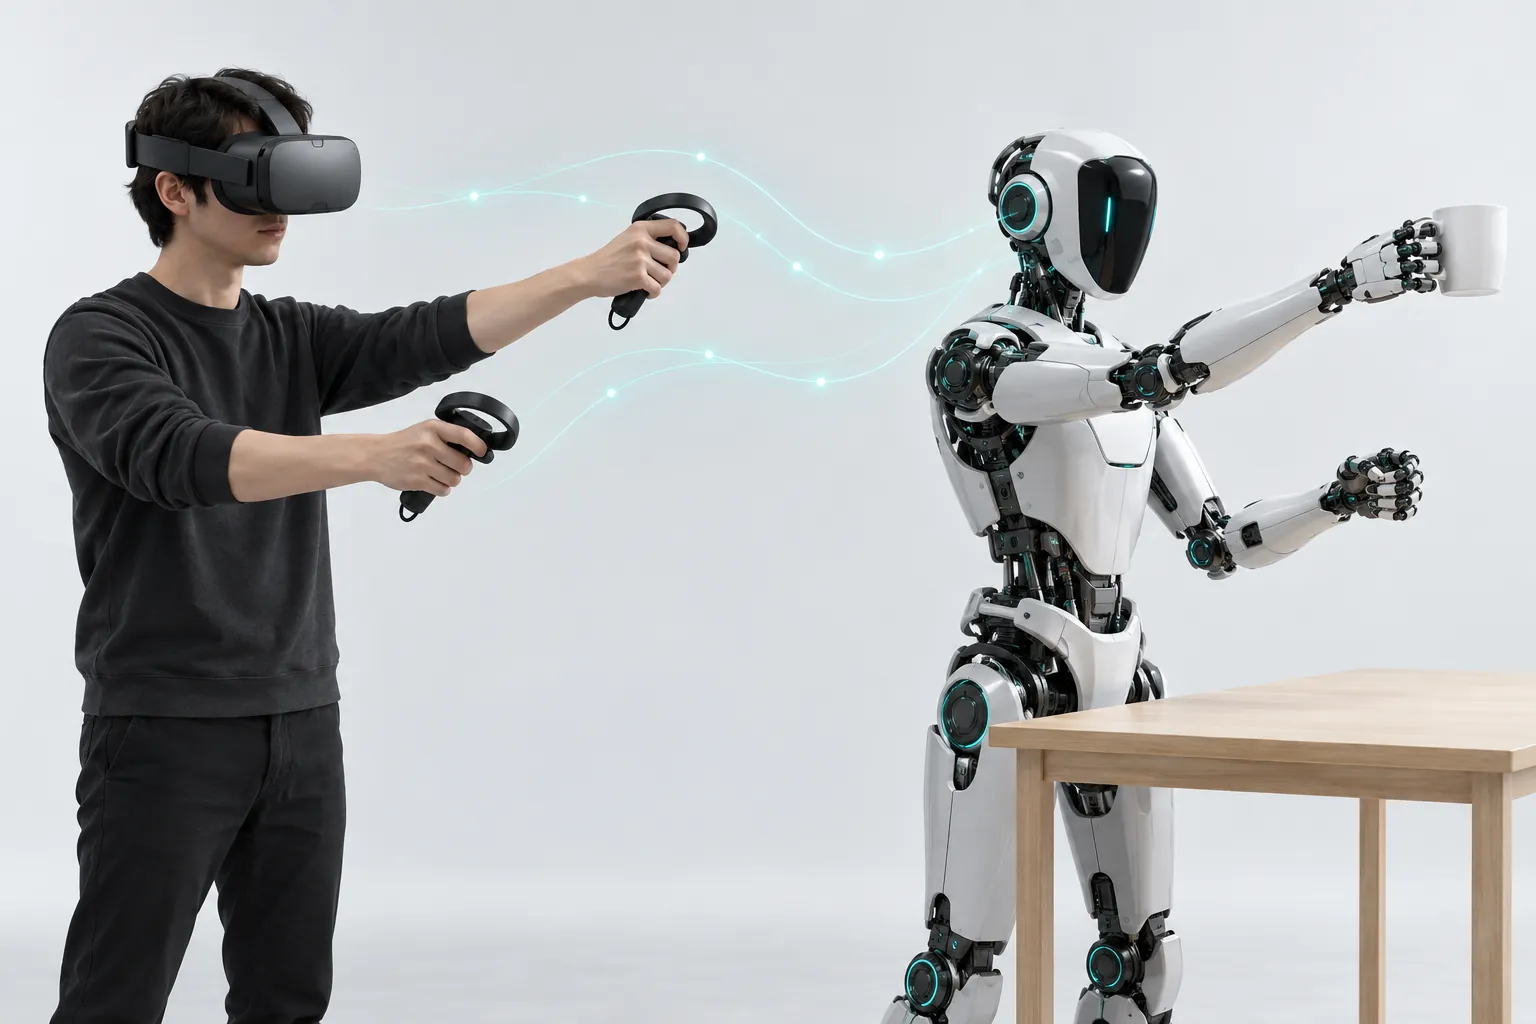
左边的人戴着 VR 头显、握着手柄做抓取动作,右边的人形机器人在桌前做出同样的姿势握住杯子,两者之间有青色光线

大脑是怎么学会的

上面三层的大模型,本事主要来自数据:人戴上 VR 头显、拿着手柄遥控机器人,一遍遍示范;再加上人类视频和仿真里生成的数据。

全身运动控制多在仿真里用强化学习练成。训练好的模型还要经过压缩和加速,才能装进机身的计算模块。

  1. 01

    采集示范

    遥操作、人类视频、动作捕捉,整理成数据集。

    数据集 26 个
  2. 02

    仿真练习

    在虚拟世界里大量练习,再用评测基准比较好坏。

    仿真与评测 64 个
  3. 03

    训练模型

    在 GPU 集群上训练、微调 VLA 和控制策略。

    训练框架 32 个
  4. 04

    部署上机

    压缩、加速,装进机身的计算模块里实时运行。

    部署推理工具 14 个

大脑装在哪

模型跑在哪,决定了它能多快。负责「想」的可以离得远一点,越往下越要贴着电机。

机身里的 AI 计算模块

大模型多跑在胸腔或背部的计算模块上。NVIDIA Jetson AGX Orin 最高 275 TOPS;2025 年 8 月发布的 Jetson AGX Thor 最高 2070 TFLOPS(FP4)、128 GB 内存、功耗 40–130 W。宇树 G1 的 EDU 版可选装 Orin 等高算力模块,Go2 EDU 标注 40–100 TOPS。

拆解图谱 · 处理器 / AI 模组

云端

更大的模型可以放在云上,但网络一来一回要时间,只适合不赶时间的任务规划;平衡和关节控制必须在本地。Figure 的 Helix 两套系统都跑在机身的嵌入式 GPU 上。

每个关节的驱动板

关节伺服跑在每个关节自己的驱动板上,紧挨着电机,离传感器和电机最近、反应最快,不经过大模型。

拆解图谱 · 电机驱动板

常见问题

机器人大脑是什么?
不是一个零件,而是跑在机器人计算模块和关节驱动板上的一组模型与程序。通常可以分成五层:感知把环境变成数据,理解与规划想清楚做什么,动作生成把意图变成连续动作,全身运动控制保持平衡,关节伺服让电机准确转动。
VLA 模型是什么?
VLA 是视觉-语言-动作模型:输入相机画面和语言指令,直接输出机器人的动作。π0、GR00T N1、OpenVLA 都属于这一类,大多用人通过遥操作示范的数据训练。
具身大脑和 VLA 有什么区别?
具身大脑负责理解和规划,输出子任务、目标位置这类高层结果;VLA 负责把意图变成具体动作。Gemini Robotics 1.5 就是这样分工:ER 1.5 安排任务,VLA 输出电机指令。也有模型把两者合在一起。
为什么要分快慢两套系统?
大模型想得深但算得慢:70 亿参数的 OpenVLA 在一张 RTX 4090 上每秒约推理 6 次,而控制手臂要每秒几十到几百次。把「想」交给慢系统、「动」交给小而快的动作模型,两头都能兼顾。Figure 的 Helix 慢系统每秒 7–9 次,快系统每秒 200 次。
世界模型是用来做什么的?
世界模型预测「接下来会发生什么」,主要用来生成合成训练数据、在动手前预演几种做法,以及不上真机就给策略打分。
有了大模型,还需要运动控制吗?
需要。平衡和关节控制要每秒几十到几千次地修正,大模型来不及。这两层多由强化学习策略和经典控制算法负责,比如宇树开源的强化学习策略每秒运行 50 次,输出关节目标角度,再由 PD 控制器换成电机力矩。
机器人的大脑装在身上还是在云端?
控制相关的部分必须装在身上,Figure 的 Helix 就完全跑在机身的嵌入式 GPU 上。更大的规划模型可以放在云端,但网络延迟让它只适合不赶时间的任务规划。

资料来源

页面上的具体数字都来自下列公开资料;模型的介绍取自模型库,每个项目的出处见各自的详情页。配图是概念教学示意,不是某家机器人的实物。

  1. Figure · Helix: A Vision-Language-Action Model for Generalist Humanoid Control(2025-02-20)慢系统 70 亿参数、每秒 7–9 次;快系统 8000 万参数、每秒 200 次、35 个自由度;完全跑在机身嵌入式 GPU 上
  2. NVIDIA · GR00T N1: An Open Foundation Model for Generalist Humanoid Robots(arXiv 2503.14734)慢系统 Eagle-2 视觉语言模型在 L40 上每秒 10 次;快系统流匹配动作模型每秒 120 次
  3. Physical Intelligence · π0: A Vision-Language-Action Flow Model for General Robot Control(arXiv 2410.24164)30 亿参数 PaliGemma 加 3 亿参数动作专家,流匹配,最高每秒 50 次
  4. Google DeepMind · Gemini Robotics 1.5 brings AI agents into the physical world(2025-09-25)ER 1.5 像高层大脑一样安排任务,Robotics 1.5 把画面和指令变成电机指令
  5. Google Developers Blog · Building the next generation of physical agents with Gemini Robotics-ER 1.5ER 1.5 可以调用 VLA 或其他自定义函数
  6. OpenVLA: An Open-Source Vision-Language-Action Model(arXiv 2406.09246)70 亿参数,在一张 RTX 4090 上约每秒 6 次
  7. Rudin 等 · Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning(arXiv 2109.11978)走路策略每秒 50 次,输出关节目标位置,由 PD 控制器产生电机力矩
  8. 宇树 · unitree_rl_gym(GitHub)默认仿真步长 0.005 秒、每 4 步决策一次,即每秒 50 次;真机部署 control_dt 0.02 秒
  9. 宇树 · unitree_sdk2 底层控制示例(GitHub)G1、Go2 底层控制示例的指令周期 2 毫秒,即每秒 500 次
  10. ODrive Robotics · ODrive Pro 产品页电机驱动控制环 8 kHz
  11. The Mini Wheelbot(arXiv 2502.04582)研究样机的 FOC 控制环 40 kHz
  12. Intel RealSense · D400 系列技术手册深度相机最高每秒 90 帧
  13. NVIDIA · Jetson Thor最高 2070 TFLOPS(FP4)、128 GB 内存、40–130 W
  14. NVIDIA · Jetson OrinAGX Orin 最高 275 TOPS
  15. 宇树 · G1 官方参数EDU 版可选装 Orin 等高算力模块
  16. 宇树 · Go2 官方参数EDU 版高算力模块 Orin(40–100 TOPS)

接着看