强化学习
Reinforcement Learning (RL)
强化学习让机器人靠试错和奖励学动作。足式和人形的运动控制多在仿真里大规模并行训练,再把策略部署到真机。
又称 深度强化学习、RL、DRL
强化学习是什么
强化学习让机器人靠试错学动作:没人告诉它每一步该做什么,只给一个奖励分数,它自己试出得分最高的做法。
在机器人上,这个「试」主要放在仿真里。任务越复杂,训练要的数据越多,所以多数工作先在仿真里训练,再迁移到真机。在现实中训练人形爬楼梯,还可能损坏机器、伤到身边的人。
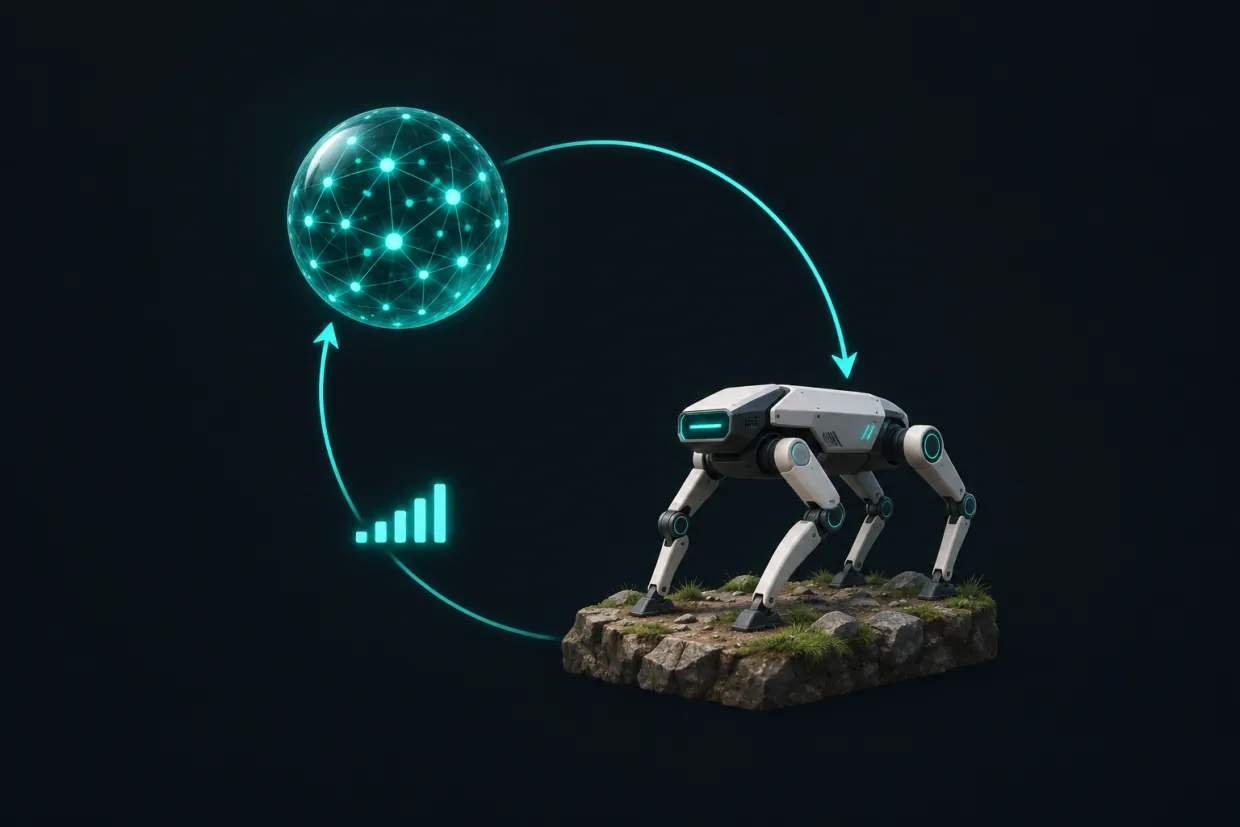
练出来的是一个策略网络。以 Rudin 等人的四足行走为例,它输入身体速度、重力方向、关节状态和地形信息,输出各关节的目标位置,再由 PD 控制器算出电机力矩。
在机器人里做什么
四足行走
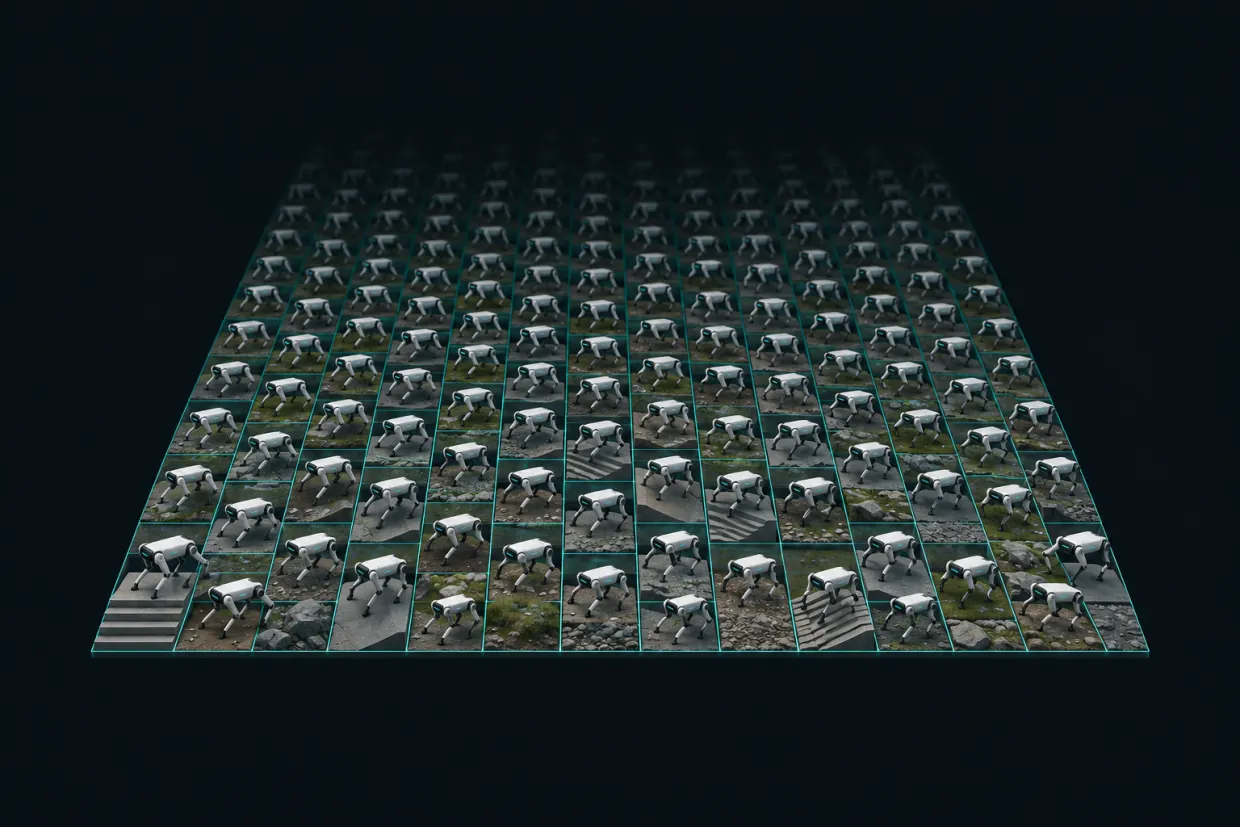
Rudin 等人在一张工作站 GPU 上并行模拟上千台 ANYmal 四足机器人,平地策略不到 4 分钟练成,崎岖地形 20 分钟,再迁移到真机验证。
人形行走
宇树的 unitree_rl_gym 支持 Go2、H1、H1_2 和 G1,流程是训练、回放验证、换仿真器验证、部署真机。Radosavovic 等人的人形控制器也在仿真里训练,再零样本部署到真实世界。
灵巧手转物体
OpenAI 用强化学习训练 Shadow 灵巧手在手里转动物体。训练全在仿真里,随机化摩擦系数和物体外观,不用人类示范,策略能迁移到实物。
人形高难度全身动作
ASAP 先用人体动作数据在仿真里预训练动作追踪策略,再用真机数据训练一个动作修正模型补偿动力学差异,让宇树 G1 做出敏捷的全身动作。
给 VLA 做后训练
强化学习也用在大模型上。π*0.6 的 RECAP 方法用真实部署数据继续训练 VLA。论文称在部分最难的任务上,吞吐量翻倍以上,失败率约减半。
关键数字
- 50Hz宇树 unitree_rl_gym 的 G1 部署配置:控制周期 0.02 秒来源:github.com
- <4分钟Rudin 等人在单张工作站 GPU 上训练 ANYmal 平地行走策略的时间,崎岖地形为 20 分钟来源:arxiv.org
- 2048–4096台Rudin 等人的 ANYmal 任务里,同时模拟的机器人数量的最佳折中来源:arxiv.org
- 2–3个数量级Isaac Gym 论文报告的训练提速,对比 CPU 仿真加 GPU 训练的传统方案来源:arxiv.org
- 9项Rudin 等人四足行走奖励函数的加权项数来源:ar5iv.labs.arxiv.org
常见问题
- 强化学习和模仿学习有什么区别?
- 模仿学习跟着示范学,比如 ACT 用遥操作采集的示范。强化学习靠奖励和自己试,可以完全不用示范。两者也能结合:RECAP 同时用示范、机器人自己采的数据和人工干预。
- 为什么机器人强化学习要在仿真里练?
- 强化学习要大量试错,这限制了它在真实世界的使用。仿真里没有安全问题,还能大规模并行。Isaac Gym 把物理仿真和策略训练都放在 GPU 上,一张卡能同时跑上万个环境。
- 仿真里练好的策略,上真机为什么会变差?
- 仿真和真实的动力学对不上。常见对策有三类:系统辨识把参数测准,域随机化把仿真参数打乱,学习真实动力学。域随机化可能让策略过于保守。Rudin 等人随机化了地面摩擦,还加观测噪声和随机推搡。
- 机器人的奖励函数怎么设计?
- 通常是多项加权。Rudin 等人的四足行走用 9 项:主项鼓励跟随速度指令,再惩罚关节力矩、关节加速度和碰撞,让动作更平滑。机身触地算摔倒,直接重置。
- 机器人强化学习一定要用仿真吗?
- 不一定。DayDreamer 借助世界模型直接在真机上学,四足机器人 1 小时学会行走。RECAP 也是在真实部署中继续学习。不过多数工作还是先仿真后真机。
- 训练需要什么硬件?
- 看任务。Rudin 等人的四足行走只用一张工作站 GPU。Isaac Gym 让原本要数据中心的实验能在桌面机上跑。灵巧手任务重得多:OpenAI 转方块的任务最长训练 14 天,解魔方的策略要几个月。
来源
- Sutton & Barto · Reinforcement Learning: An Introduction(第二版,作者官网 PDF)incompleteideas.net
- Rudin 等 · Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning(arXiv 摘要页)arxiv.org
- Rudin 等 · Learning to Walk in Minutes 论文 PDFarxiv.org
- Rudin 等 · Learning to Walk in Minutes(ar5iv HTML 版)ar5iv.labs.arxiv.org
- NVIDIA · Isaac Gym: High Performance GPU-Based Physics Simulation For Robot Learning(arXiv 摘要页)arxiv.org
- NVIDIA · Isaac Gym 论文 PDFarxiv.org
- 宇树 · unitree_rl_gym README(GitHub)github.com
- 宇树 · unitree_rl_gym G1 部署配置 g1.yaml(GitHub)github.com
- Radosavovic 等 · Real-World Humanoid Locomotion with Reinforcement Learning(arXiv 2303.03381)arxiv.org
- OpenAI · Learning Dexterous In-Hand Manipulation(arXiv 1808.00177)arxiv.org
- He 等 · ASAP: Aligning Simulation and Real-World Physics for Learning Agile Humanoid Whole-Body Skills(arXiv 2502.01143)arxiv.org
- Physical Intelligence · π*0.6: a VLA That Learns From Experience(arXiv 2511.14759)arxiv.org
- Wu 等 · DayDreamer: World Models for Physical Robot Learning(arXiv 2206.14176)arxiv.org
- Zhao 等 · Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware(ACT,arXiv 2304.13705)arxiv.org
核验于 2026-11-06